
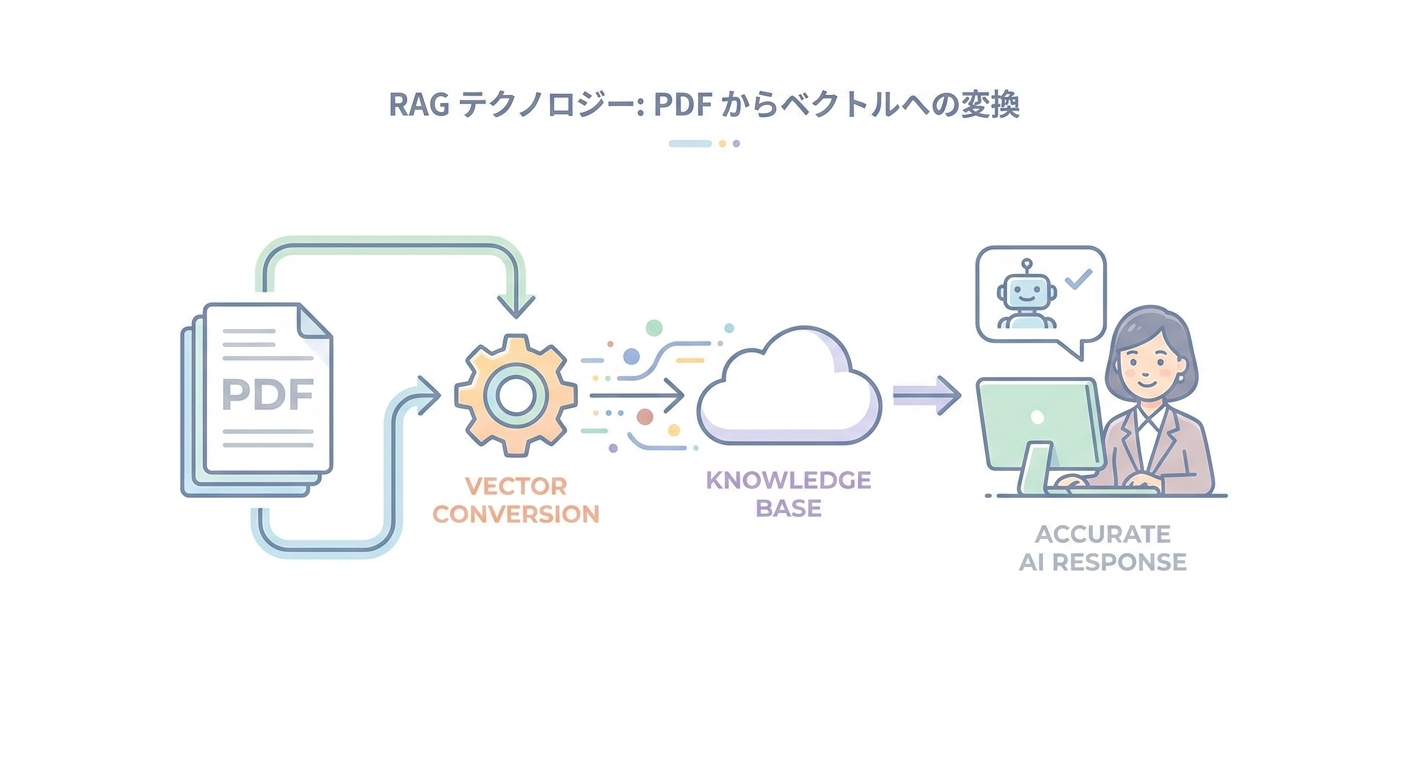
AIチャットボットが自社データを学習して正確に回答する仕組みとは、主に「RAG(Retrieval-Augmented Generation:検索拡張生成)」と呼ばれる技術を用い、PDFやWebページなどの独自文書を数値化(ベクトル化)してデータベースに格納し、質問に応じてリアルタイムに検索・抽出して回答を生成する構造のことです。AIモデル自体を巨大なコストをかけて再学習させるのではなく、外部の「ナレッジデータベース」を参照用図書としてAIに手渡すことで、最新かつ正確な社内情報に基づく応答を実現しています。
私自身、株式会社LaruVisonaの代表として多くの法人様へAIチャットボット(LARUbot)の導入・技術支援を行ってきましたが、「AIに自社データを学習させるとはどういう処理なのか」「社外に情報が漏れる心配はないのか」という疑問を頻繁にいただきます。本記事では、エンジニアではない担当者様でも理解できるよう、自社データ学習の裏側にある技術的な仕組みやメリット、導入時の注意点、選定基準を体系的にわかりやすく解説します。
なお、自社データ学習の具体的な構築手順については「AIチャットボット自社データ学習方法|失敗しないRAG構築4ステップ」、回答精度のコントロール手法については「AIチャットボットの「賢さ」はどう決まる?2026年版・自社データ学習(RAG)と対話品質のコントロール術」で詳しく解説しています。本記事では「仕組みと技術原理」に絞って深掘りしていきます。
AIチャットボットが自社データを学習する2つの仕組み
AIが自社の製品マニュアルや社内規定、Q&Aデータを踏まえて会話できるようにする技術アプローチには、大きく分けて「RAG(検索拡張生成)」と「ファインチューニング(再学習)」の2種類が存在します。現在の商用AIチャットボットの主流は圧倒的にRAGです。それぞれの仕組みの違いを把握することが、仕組み理解の第一歩となります。
1. RAG(検索拡張生成)の仕組み
RAG(Retrieval-Augmented Generation)は、「検索(Retrieval)」と「生成(Generation)」を組み合わせた仕組みです。AI(LLM:大規模言語モデル)そのものの脳みそを書き換えるのではなく、AIに「オープンブックテスト(教科書を見ながら答えるテスト)」をさせるイメージに近く、次のような流れで処理が行われます。
- 事前登録(インデックス化): 自社のPDFやWebページのテキストを細かく分解し、意味合いを数値化した「ベクトルデータ」として専用データベースに保存します。
- 質問の受領と検索(Retrieval): ユーザーから質問が届くと、その質問の意味に近いテキストをデータベースから一瞬で探し出します。
- 回答の生成(Generation): 探してきた「正確な自社データ」をAIに提示し、「この資料だけを根拠にしてユーザーに回答を作成してください」と命令(プロンプト注入)することで、正確な回答を出力させます。
この仕組みにより、AIは元々知らなかったはずの「昨日改定された自社の規約」や「新製品の仕様」についても、間違いなく回答できるようになります。
2. ファインチューニング(追加学習)の仕組み
ファインチューニングとは、すでに存在するAIモデル(LLM)に対して、自社の大量の対話データや専門文書を読み込ませ、AIモデルの内部パラメータ(重み付け)自体を直接変更・更新する仕組みです。「オープンブックテスト」ではなく、「AIの頭脳そのものを勉強させて暗記させる」方式に相当します。
特定の業界用語の言い回しや特定のトーン&マナーを叩き込むのには適していますが、自社データを更新するたびに膨大な計算費用と膨大なトレーニング時間が必要になるため、日常的に情報が変化する社内マニュアルや顧客対応の現場では実用的ではありません。
RAGとファインチューニングの比較
2つの仕組みの違いを表にまとめました。なぜ現代のAIチャットボットがRAGベースの自社データ学習を採用しているのかが明確に分かります。
| 比較項目 | RAG(検索拡張生成) | ファインチューニング(追加学習) |
|---|---|---|
| 基本構造 | 外部データを検索して回答に添付する | AIモデル内部の重みを直接更新する |
| データ更新速度 | 即時(ファイルを登録・差し替えるだけ) | 遅い(数時間〜数日間の再学習が必要) |
| 導入・運用コスト | 低価格〜中価格帯 | 非常に高額(サーバー費・開発費) |
| 根拠の明確性 | 高い(参照した元文書を提示可能) | 低い(どの記憶から答えたか不透明) |
| ハルシネーション抑制 | 容易(参照範囲を厳密に制限可能) | 難解(間違いを完全に防ぐのが困難) |
| 推奨される用途 | 社内FAQ・取扱説明書・CRM連携・営業資料 | 特殊な業界用語の理解・独自の口調形成 |
自社データ学習(RAG)の仕組みを支える4つの技術要素
ユーザーがアップロードしたPDFやWebサイトのURLから、AIがどのようにして回答を作り出しているのか。その内部で動いている4つのコア技術要素を解説します。
① ドキュメントチャンキング(テキストの分割処理)
100ページある製品マニュアルのPDFをそのままAIに投げ込んでも、一度に読み込める情報量(コンテキストウィンドウ)には限界があり、処理効率も落ちてしまいます。そのため、学習システムは入力されたファイルを「チャンク(意味のある塊)」と呼ばれる200〜1,000文字程度の小段落に自動分解します。
② エンベディング(テキストのベクトル数値化)
人間は文字を意味で理解しますが、コンピュータは数字しか理解できません。エンベディング(Embedding)技術を使うことで、「社内LANの設定方法」というテキストを、何千次元もの空間上の数値座標(ベクトル)へ変換します。これにより、「LANの設定」と「Wi-Fiの繋ぎ方」が、文字が違っていても「意味的に近い場所にあるデータ」としてコンピューターが認識できるようになります。
③ ベクトルデータベース(高速な意味検索エンジン)
数値化された自社データは、「ベクトルデータベース(Vector Database)」と呼ばれる専用の記憶域に保管されます。ユーザーから「パスワードを忘れた」と質問が来た際、従来のキーワード検索(完全一致)ではなく、意味の近さを計算する「近接検索(Cosine Similarityなど)」を行い、最も関連性の高い自社データの段落を数ミリ秒で検出します。
④ プロンプトインジェクションとLLMによるテキスト生成
抽出された自社データの段落と、ユーザーの質問、そして「提供された文章のみに基づいて親切に回答してください」というシステム命令(システムプロンプト)が組み合わされ、最終的にGPT-4oやGeminiなどの大規模言語モデル(LLM)へ送られます。LLMはその材料をもとに、自然で読みやすい日本語の文章を組み立ててユーザーに返答します。
AIチャットボットに自社データを学習させる3つのメリット
汎用のChatGPTなどのAIと異なり、自社データ学習機能を備えたAIチャットボットを導入することで、業務現場には以下のような強力なメリットが生まれます。
1. 自社独自の製品情報・複雑な規定へ正しく即答できる
一般のAIは公知の情報しか持っていないため、「自社製品の型番ごとのスペック」「自社サービスの解約手順」「自社固有の社内申請フロー」には答えられません。自社データ学習を行えば、自社特有のナレッジを完全にカバーした専任のアシスタントとして24時間自動応答が可能になります。
2. 専門知識がなくても、資料をアップロードするだけで即日更新できる
一昔前のルールベース(シナリオ型)チャットボットのように、一問一答の分岐ツリーを手作業で何百個も構築する必要はありません。すでに社内にある業務マニュアルPDFや、公式サイトのWebページのURLを入力するだけで、AIが自動で内容を読み込んで回答可能な状態にしてくれます。仕様変更があった場合も、該当のファイルを差し替えるだけで最新の回答へ一瞬で更新されます。社内ナレッジの自動学習と活用については「AIチャットボット社内ナレッジ自動学習の仕組みと実践ガイド」でも詳しく解説しています。
3. 入力データがAIの公開学習に使われない安全性が確保される
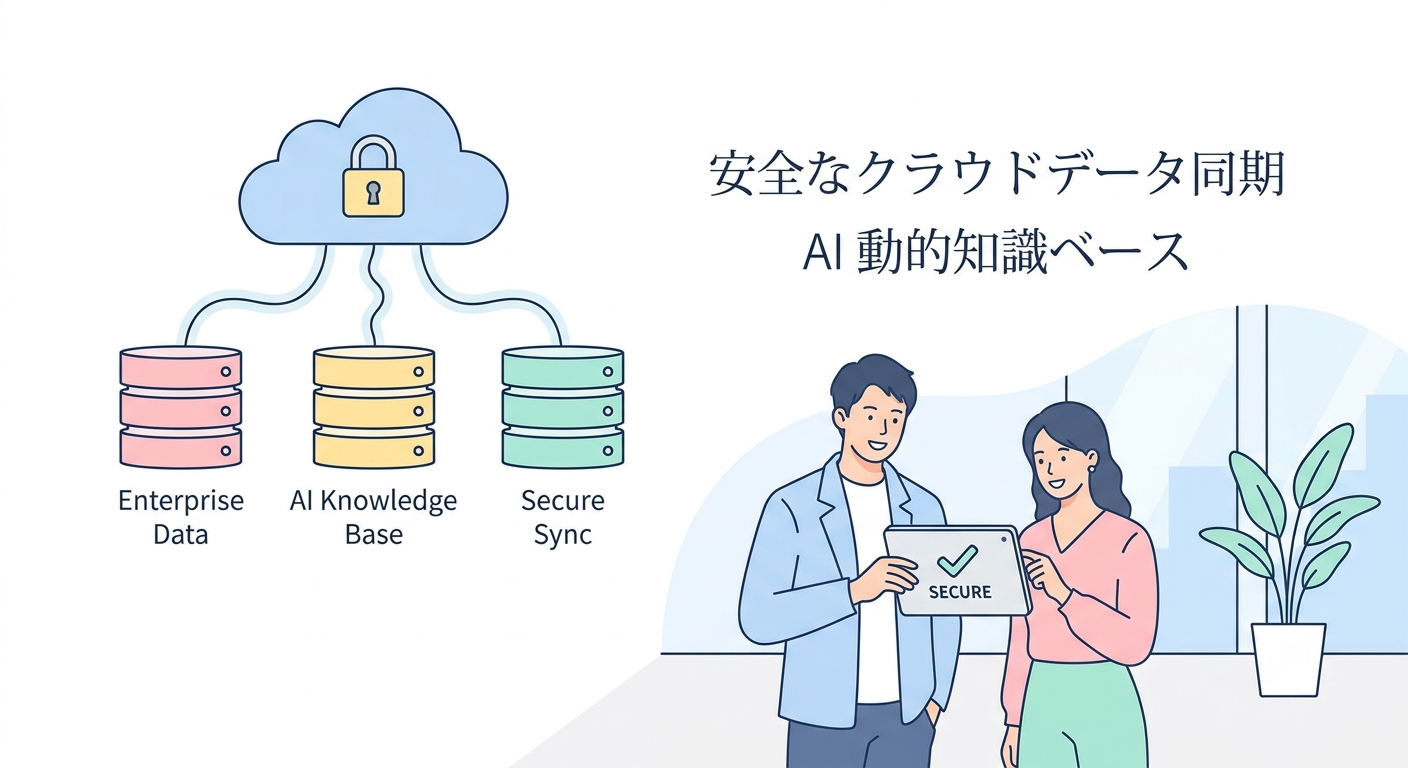
個人向けの無料AIチャットサービスでは、入力した文章がAIモデル全体の再学習に利用され、他人の回答として流出するリスクが懸念されます。しかし、法人向けの自社データ学習型AIチャットボット(例:LARUbotなど)では、APIを経由したデータ処理を行っており、アップロードした社内文書や顧客との対話データが独自AIモデルの汎用学習に使用されないセキュリティ構造が徹底されています。
自社データ学習の仕組みにおける注意点と限界
非常に便利な自社データ学習(RAG)ですが、技術的な仕組みに起因する限界や注意点も存在します。これらを正しく理解しておくことが、導入後のミスマッチを防ぐ鍵となります。
1. 元データ(PDF・Web)の品質に精度が100%依存する
「Garbage In, Garbage Out(ゴミを入れれば、ゴミが出てくる)」の原則通り、元となるマニュアルやQ&Aの記述が曖昧だったり、古い情報と新しい情報が混ざっていたりすると、AIも誤った回答を出力します。また、画像化されたスキャンPDFや、極端に崩れた複雑な表組みデータはテキスト抽出に失敗し、参照されないケースがあります。
2. ハルシネーション(知ったかぶりの嘘)をゼロにはできない
RAGによって根拠となる自社データを与えても、LLMが文章を生成する際の文脈解釈によって、実在しない仕様をもっともらしく語ってしまう「ハルシネーション」が発生する可能性はゼロではありません。回答プロンプトで「資料に記載がない場合は『わかりかねます』と答えてください」という制約を強固にかける仕組み(グラウンディング)が必要です。
3. システムの統合範囲によって「できること」が変わる
単にQ&Aに答えるだけの単体チャットボットの場合、顧客の過去の購入履歴や商談進捗に応じた個別の回答はできません。顧客ごとの文脈を踏まえた自社データ活用を行うには、チャットボットが顧客管理システム(CRM)やSFAと連携している必要があります。CRM連携の詳細については「国産AIチャットボットCRM連携とは?仕組みと選び方を解説」をご覧ください。
自社データ学習AIチャットボットの主要サービス比較
自社データ学習機能を備えた主要なAIチャットボットの価格や特徴、向いている用途の比較表です。ツール選定の参考にしてください。
| サービス名 | 月額料金帯 | データ学習方法 | 統合機能(CRM/決済等) | 向いている事業者・用途 |
|---|---|---|---|---|
| LARUbot | 27,500円〜 | PDF・Web URL・Q&A(RAG) | 標準統合(CRM/MA/チャット内決済※) | 顧客対応・売上自動化・業務集約を目指す全事業者 |
| 海外製RAGツールA | 要問い合わせ(ドル建て) | PDF・テキストファイル | なし(API連携が必要) | 自社でエンジニアを抱えるIT企業 |
| 国産FAQ特化ボットB | 50,000円〜 | CSV・Excelインポート | なし(回答専用) | 社内ヘルプデスク・問い合わせ一次受けのみ |
※チャット内決済機能は提供準備中(Stripe連携)。最新の価格・仕様は各社公式サイトをご確認ください。
自社データ学習とビジネス自動化を高度に融合する「LARUbot」
自社データを学習させて問い合わせ対応を自動化するだけでなく、顧客の管理や商談の進捗追跡までを一元化したい企業に選ばれているのが、次世代ビジネスOS「LARUbot」です。
LARUbotは、東京都豊島区の株式会社LaruVisonaが提供する国産オールインワンAI SaaSです。自社データ学習(RAG)の仕組みを極限までシンプル化しており、プログラミングや複雑な設定は一切不要。お持ちのWebサイトのURLやPDF資料をアップロードするだけで、最短10分で自社専用の高度なAIチャットボットが完成します。
- 学習データの安全性を確保: 入力された各種データや会話ログを当社独自AIモデルの学習に使用することはありません。セキュリティ基準の高いAWSインフラ上で安全に運用されます。
- データ分断を防ぐ統合構造: AIチャットボット、顧客・案件管理(CRM/SFA)、マーケティング自動化(MA)、チャット内決済(提供準備中)が1つのOSとして統合されています。
- 初期費用0円&初月無料: 月額27,500円(Starter)から導入可能で、初期費用は0円。約30日間の無料トライアルで全機能を実際の業務環境でお試しいただけます。
さらに、Web上のやり取りだけでなく、お電話での問い合わせ業務も自動化したい場合は、AI電話受付サービス「LARU CALL」(月額5,980円(税別)〜)や、集客コンテンツを自動生成する「LARU SEO」を組み合わせることで、デジタルとリアルの全顧客接点をAIで自動化する強力な体制が整います。
AIチャットボットの自社データ学習に関するよくある質問
Q. 自社データの学習にはプログラミングやエンジニア作業が必要ですか?
いいえ、ノーコードで完結します。管理画面からPDFやCSVファイルをドラッグ&ドロップでアップロードするか、参照させたいWebサイトのURLを入力するだけで、AIが自動でテキストを抽出・ベクトル化して学習を完了させます。
Q. アップロードした自社データが他社のAI回答に漏洩することはありませんか?
ありません。法人向けの自社データ学習プラットフォームでは、API経由でデータを保持・参照する仕組みをとっており、入力データや学習用ファイルをAIモデル全体のパブリック学習に利用しない契約・仕様となっています。ご安心ください。
Q. 社内マニュアルの更新頻度が高い場合、再学習の作業は大変ですか?
RAG(検索拡張生成)の仕組みを採用しているため、再学習のコストや時間はかかりません。古いファイルを削除して新しいPDFをアップロードする、あるいはURLの再読み込みボタンを押すだけで、数秒〜数分で最新のナレッジが反映されます。
まとめ:自社データ学習の仕組みを理解し、AIを強力な事業エンジンへ
AIチャットボットの自社データ学習は、外部の知識データベースとLLMをリアルタイムに結びつける「RAG(検索拡張生成)」の仕組みによって成り立っています。この構造を理解することで、なぜPDFやURLを入れるだけで賢くなるのか、どのようにセキュリティが保たれているのかがクリアになったかと思います。
単なる「質問回答ボット」にとどまらず、自社データを学習したAIが顧客対応から案件管理、商談の自動化までを担う時代です。自社ナレッジの活用や業務自動化をご検討中の方は、初期費用0円・初月無料で全機能を試せる「LARUbot」で、その驚くべき精度と利便性をぜひ体感してみてください。
執筆:齋藤 匠(株式会社LaruVisona 代表取締役)
最新のAI技術とビジネス現場の課題解決を融合させる「ビジネスOS」の構築を推進。自社データ学習(RAG)を活用した業務効率化・売上自動化に関するコンサルティングを多数手掛ける。