
AIチャットボットに自社データを学習させる最も効率的な方法は、RAG(検索拡張生成)技術を搭載したノーコードツールを活用し、PDFやWebサイトのURLをそのまま読み込ませることです。この方法であれば、開発コストをかけず、最短10分程度で自社専用のAIチャットボットを構築できます。具体的な手順は、①学習目的の定義、②データの整理・整形、③ツールへの登録、④テストとプロンプト調整、という4つのステップを順に進めるだけで完了します。
自社データを学習させる前に知っておくべき前提と準備物
AIチャットボットに自社の製品情報や社内マニュアルを学習させる前に、どのような準備が必要で、どのような点に注意すべきかを整理します。これらを事前に把握しておくことで、導入後の手戻りを防ぎ、スムーズな運用が可能になります。
学習に必要な3つの準備物
- 自社データ(ナレッジソース):PDF形式のマニュアル、仕様書、Q&Aリスト(CSVやExcel)、または自社製品の紹介が掲載されているWebサイトのURLなど。
- RAG対応のAIチャットボットツール:外部データを安全に読み込み、リアルタイムで検索・回答に反映できるシステム(例:AIチャットボット(LARUbot))。
- テスト用の質問リスト:「実際のユーザーや社員がどのような言葉で質問するか」を想定した、10〜20件程度のテスト用クエリ。
学習プロセスでつまずきやすい3つのポイント
- データの「ノイズ」による精度低下:PDF内の複雑なレイアウト(2段組や表組み、画像化された文字など)は、AIがテキストを正しく読み取れず、誤回答の原因になります。
- ハルシネーション(もっともらしい嘘):学習データに記載されていない質問に対し、AIが一般的な知識をベースに「嘘の回答」を創作してしまうことがあります。
- 情報漏洩(セキュリティ)のリスク:パブリックな生成AIサービスに機密データをそのまま入力すると、そのデータがAIモデルの再学習に使用され、他者に漏洩する危険性があります。
AIチャットボットに自社データを学習させる4つの手順
自社データをAIチャットボットに学習させ、実用的なレベルに仕上げるための具体的な手順を解説します。以下の4つのステップに沿って進めることで、技術的な知識がない担当者でも、高精度な自社専用AIを構築できます。
-
ステップ1:学習させる目的と対応範囲を明確にする
まずは、AIチャットボットを「誰向けに」「何の目的で」導入するのかを明確にします。例えば、「一般顧客からの製品仕様に関する問い合わせ対応(カスタマーサポート)」なのか、「社内メンバーからの経費精算や社内規定に関する質問対応(ヘルプデスク)」なのかによって、学習させるべきデータの範囲は大きく異なります。
目的が曖昧なまま、社内にあるすべてのドキュメントを無差別に学習させると、AIが関係のない情報を参照してしまい、回答精度が低下します。まずは「よくある質問トップ50」や「特定の製品マニュアル1冊」など、範囲を絞ってスタートすることが成功の鉄則です。
-
ステップ2:学習データを整理・整形する(最重要プロセス)
AIが正確に情報を検索・参照できるように、学習データを「AIが読み取りやすい形式」に整理(前処理)します。このプロセスが、チャットボットの回答精度を左右する最も重要な工程です。
具体的には、PDFやテキストファイルから不要な改行、記号、重複する表現を削除します。また、複雑な表組みやグラフ、画像の中に含まれるテキストは、AIが構造を理解しにくいため、以下のように「箇条書き」や「シンプルなテキスト形式」に書き換えておきます。
【修正前(複雑な表)】 製品A:価格10万円、保証1年、対象BtoB 製品B:価格15万円、保証2年、対象BtoC 【修正後(AIが理解しやすいテキスト)】 ・製品Aの価格は10万円です。保証期間は1年間で、主にBtoB(法人向け)を対象としています。 ・製品Bの価格は15万円です。保証期間は2年間で、主にBtoC(個人向け)を対象としています。 -
ステップ3:AIチャットボットツールにデータをアップロードする
整理したデータを、選定したAIチャットボットツールに登録します。例えば、国産のオールインワンAI SaaSであるLARUbotの場合、管理画面からPDFファイルをドラッグ&ドロップするか、学習させたいWebサイトのURLを入力するだけで登録が完了します。
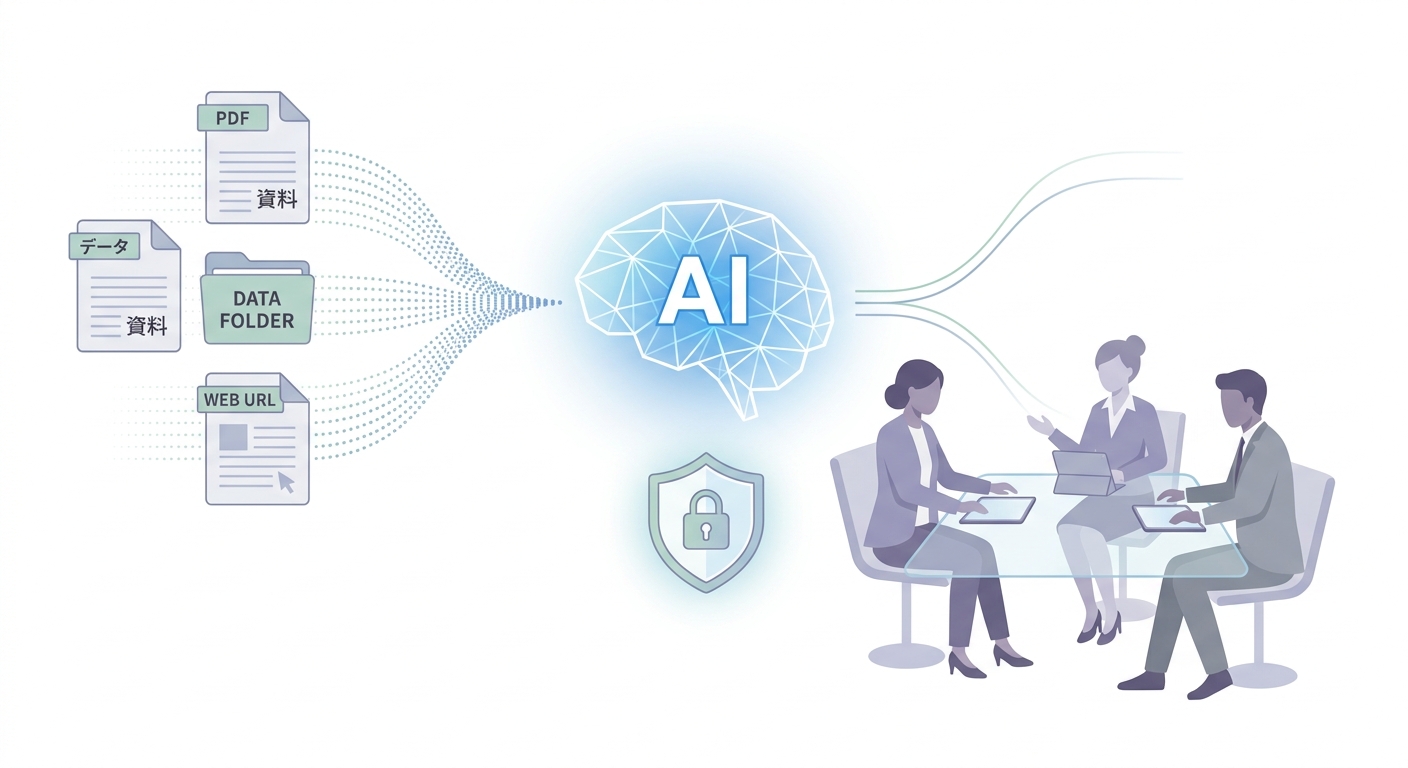
システムの裏側では、アップロードされたドキュメントが自動的に適切なサイズ(チャンク)に分割され、意味的な類似性を計算できる「ベクトルデータ」に変換されてデータベース(ベクトルDB)に保存されます。この高度なRAG(検索拡張生成)処理がすべて自動で行われるため、プログラミングやAIの専門知識は一切不要です。
-
ステップ4:テスト対話を行いプロンプトを調整する
データの登録が完了したら、管理画面のプレビュー機能やテスト対話画面を使い、実際に想定される質問を投げかけてみます。AIが登録したデータに基づいて、正確な回答を生成できるかを確認します。
もし回答のニュアンスが硬すぎたり、データにないことを勝手に回答してしまったりする場合は、システムプロンプト(AIへの指示文)を調整します。例えば、「回答は必ず提供されたデータのみに基づいて作成し、データにない場合は『申し訳ございませんが、その質問にはお答えできません』と回答してください」といった制約を加えることで、ハルシネーション(誤回答)を劇的に防ぐことができます。
【徹底比較】自社データを学習させる3つのアプローチと違い
「自社のデータをAIに学ばせる」と一口に言っても、その技術的なアプローチにはいくつかの種類があります。2026年現在、企業が実務で導入する手法は、主に以下の3つに大別されます。それぞれの難易度、コスト、向いている用途を比較表にまとめました。
| 学習方法 | 仕組み | 導入難易度 | コスト感 | ハルシネーション(誤回答)のリスク | 向いている用途 |
|---|---|---|---|---|---|
| RAG(検索拡張生成) | 質問に関連する社内ドキュメントをデータベースから瞬時に検索し、その内容をAIに参照させて回答を生成する。 | 低い(ノーコードツールで即日導入可能) | 低〜中(月額のツール利用料のみ) | 極めて低い(参照元を明示できるため) | 社内マニュアル、製品仕様書、FAQ、規程集などの膨大なデータの学習。 |
| プロンプトエンジニアリング | AIへの指示文(プロンプト)の中に、前提となる自社データを直接貼り付けて回答させる。 | 極めて低い(今すぐ試せる) | 無料〜低(APIのトークン消費のみ) | 低い(ただし情報量に限界あり) | 単発の文書要約、数ページの資料に基づく一時的な回答生成、メール文面の作成など。 |
| ファインチューニング | AIモデル自体のパラメータ(脳の構造)を、自社データを使って直接書き換えて再学習させる。 | 高い(AIエンジニアやデータサイエンティストが必須) | 高い(GPUの学習コスト、人件費、開発工数) | 高め(モデルが自律的に学習するため、コントロールが難しい) | 業界特有の専門用語や特殊な業界知識の理解、回答スタイル(トーン&マナー)の根本的な変更。 |
表から分かるように、一般的な企業が社内ナレッジや製品情報をAIチャットボットに学習させる場合、RAG(検索拡張生成)が圧倒的な最適解となります。ファインチューニングは、モデル自体に新しい知識を「染み込ませる」手法ですが、データの更新(例えば、製品の価格改定やマニュアルの改訂)のたびに膨大なコストをかけて再学習を行う必要があり、実務での運用コストが合いません。
一方、RAGであれば、PDFを差し替える、あるいはWebサイトのURLを再読み込みさせるだけで、一瞬で最新のデータがAIの回答に反映されます。このRAGの仕組みや、対話品質をコントロールするための具体的なテクニックについては、こちらの記事『AIチャットボットの「賢さ」はどう決まる?2026年版・自社データ学習(RAG)と対話品質のコントロール術』でさらに詳しく解説していますので、合わせて参考にしてください。
自社データ学習でつまずきやすい3つの「落とし穴」と具体的な対策
AIチャットボットに自社データを学習させても、「思ったような精度が出ない」「ユーザーに誤った情報を案内してしまった」というトラブルは少なくありません。ここでは、実務でよく発生する3つの落とし穴と、それらを回避するための具体的な対策を解説します。
落とし穴1:PDFやドキュメントの「データ構造」が乱れている
多くの企業が「手元にあるマニュアル(PDF)をそのままアップロードすれば完璧に回答してくれる」と誤解しています。しかし、AIは人間のように「見た目のレイアウト」を直感的に理解しているわけではありません。特に、2段組のレイアウト、複雑に結合された表組み、画像としてスキャンされただけのPDF(テキストデータが埋め込まれていないもの)などは、AIが文字の並び順や意味を誤認する原因になります。
【対策】
学習させるドキュメントは、可能な限り「シンプルな1行ずつのテキスト」や「Markdown(マークダウン)形式」に整形します。また、スキャンしたPDFは必ずOCR処理を行い、テキスト情報が正しく抽出できる状態にしてからツールに読み込ませてください。このあたりの初期設定や導入後のギャップを埋めるためのロードマップは、『AIチャットボット導入後の壁|成果が出ない5つの「落とし穴」と処方箋【2026年版】』でも詳しく紹介しています。
落とし穴2:学習データにない「想定外の質問」への制御ができていない
AIチャットボットは、学習データに記載されていない質問をされた際、その質問を無視するのではなく、自分が持っている一般的なインターネット上の知識から「それらしい回答」を作り出してしまう特性(ハルシネーション)があります。これが企業の公式チャットボットで発生すると、顧客に対して存在しない割引サービスや誤った仕様を案内してしまうといった重大なリスクにつながります。
【対策】
AIの行動を制御するために、「二刀流プロンプト」や厳格なシステム指示(システムプロンプト)を設定します。例えば、「提供されたコンテキスト(学習データ)に明確な記載がない場合は、推測で答えず、必ず『その件については分かりかねます。恐れ入りますが、担当者へ直接お問い合わせください』と回答してください」という指示をプロンプトに記述します。これにより、AIが勝手な嘘をつくリスクをほぼゼロに抑えることができます。
落とし穴3:無料のパブリックAIツールに機密データを学習させてしまう
手軽だからといって、個人向けの無料生成AIサービスや、データ保護の規約が曖昧な海外製ツールに自社の機密情報(顧客情報、未公開の技術仕様、社外秘の業務マニュアルなど)をアップロードしてしまうケースがあります。多くの無料サービスでは、ユーザーが入力したデータが「AIモデルの品質向上のための学習データ」として二次利用される規約になっており、将来的に他者の回答として自社の機密情報が出力されてしまうという致命的なセキュリティ事故を招きます。
【対策】
法人向けの、セキュリティが担保された国産のAIチャットボットツールを選定することが必須です。例えば、当社の提供するAIチャットボット(LARUbot)では、AWS(Amazon Web Services)のセキュアなクラウドインフラを採用しており、「ユーザーが入力した情報やアップロードされたデータを、当社および外部のAIモデルの学習に一切使用しない」ことを明記しています。社内データや顧客との対話ログを安全に保護しながら、安心してビジネスにご活用いただけます。
【2026年最新】自社データ学習を成功させるツール選びの基準
自社データを学習させて成果を出すためには、どのような基準でAIチャットボットツールを選ぶべきでしょうか。2026年現在、単に「PDFを読み込める」だけのツールは珍しくありません。実務で本当に使えるツールを選ぶための3つの基準を提示します。
1. データの登録・更新がノーコードで完結するか
ビジネスの現場では、製品の仕様変更や価格改定、社内ルールの変更が頻繁に発生します。その都度、エンジニアに依頼してデータベースを更新したり、複雑なAPIを叩いたりする必要があるツールでは、運用が回りません。現場の担当者が、管理画面からPDFファイルをドラッグ&ドロップするだけ、あるいは新しいWebページのURLを入力するだけで、瞬時にAIの学習データを更新できる「完全ノーコード」のツールを選ぶことが重要です。
2. チャットボット単体で終わらず、実務の「自動化」に繋げられるか
自社データを学習したチャットボットが、ユーザーの質問に「答えるだけ」では、業務効率化のインパクトは限定的です。優秀なチャットボットは、会話の中で顧客のニーズをヒアリングし、そのまま顧客管理システム(CRM)にデータを登録したり、見積書を自動生成して送付したり、その場で決済までを完了させたりする能力を持っています。
当社の提供するLARUbotは、単なるチャットボットではなく、顧客管理(CRM)、マーケティング自動化(MA)、チャット内決済システム(Stripe連携)を一つに統合した「次世代のビジネスOS」です。AIが自社データをベースに顧客対応を行いながら、商談の確度(BANT条件)を自律的に判定し、見積書の自動作成・送信や決済までを一気通貫で自動化します。詳しい機能や導入効果については、『LARUbot徹底解説|機能から導入事例、料金まで網羅』をご覧ください。
3. 明確で導入しやすい料金体系と、手厚いサポートがあるか
初期費用が高額であったり、最低利用期間の縛りがあったりするツールは、自社データ学習の精度をテストする段階でのリスクが高くなります。初期費用0円で、いつでも解約可能な、リスクの低い料金プランを提供しているベンダーを選ぶべきです。
LARUbotでは、企業の規模や目的に合わせて選べる3つのシンプルなプランを用意しています。どのプランも初期費用は0円、最低利用期間の縛りはなくいつでも解約可能です。
LARUbotの料金プランと機能比較
| プラン名 | 月額料金(税別) | 自社データ学習(RAG)機能 | 主な特徴・機能 | 向いている企業・用途 |
|---|---|---|---|---|
| Starter | 27,500円 | 対応(PDF・WebサイトURL・Q&Aの登録) | LINE公式アカウント連携(1:1自動応答)、1行タグ設置、メールサポート | まずは低コストで自社データ学習型のチャットボットをWebサイトやLINEに導入したい企業。 |
| Professional | 55,000円 | 対応(PDF・WebサイトURL・Q&Aの登録) | Starterの全機能、チャット内決済(Stripe・当社手数料0円)、PWAアプリ化、Push・LINE一斉配信、分析レポート、Webフォーム、API・Webhook連携、チーム最大5名、チャットサポート | チャットボットから直接決済や予約を受け付け、外部ツールとの連携も行いたい成長企業。 |
| LARU Cloud | 88,000円 | 対応(PDF・WebサイトURL・Q&Aの登録) | Professionalの全機能、顧客・案件管理(CRM/SFA)、メール受信箱・カレンダー連携、メール自動配信(MA)・自動化、チーム無制限、優先サポート | 問い合わせ対応から顧客管理、商談化、見積作成、決済までを自律的に完全自動化したい本格的な企業。 |
さらに、SEO集客を自動化するオプション「LARU SEO」(月額15,000円〜)をどのプランにも追加でき、チャットボットの導入と同時にホームページの集客力を強化することも可能です。また、すべてのプランで初月無料(約30日間)の全機能トライアルを提供しているため、実際の自社データを読み込ませて、AIの回答精度や使い勝手を事前にノーリスクで検証していただけます(※無料トライアル中に作成したデータは、本契約後もそのまま引き継がれます)。詳しくは料金プランページをご確認ください。
また、テキストチャットだけでなく「会社の電話対応も自動化したい」という企業向けに、AI電話受付サービス『LARU CALL』も別契約(月額5,980円〜、初期費用0円)にて提供しています。会社の電話をAIが24時間体制で受け付け、用件や折り返し先をヒアリングして担当者に通知するサービスで、はっきりとした営業・勧誘電話をAIが自動でお断りする「自動お断り機能」も搭載しています。LARU Cloudと組み合わせることで、電話の受付内容を顧客・案件管理へシームレスにつなげることも可能です。
自社データ学習に関するよくある質問(FAQ)
Q: 自社データを学習させる際、プログラミング知識は必要ですか? いいえ、一切必要ありません。LARUbotは完全ノーコードの設計となっており、管理画面からお手持ち of PDFファイルをアップロードするか、学習させたいWebサイトのURLを入力するだけで、AIが自動的にその内容を学習(RAG構築)します。専門的な技術スタックや開発工数をかけることなく、導入後すぐに自社専用のAIチャットボットとして稼働させることができます。 Q: PDFやURLを読み込ませた後、どれくらいで回答に反映されますか? アップロードまたはURLの登録後、通常は数分程度でAIの学習処理が完了し、回答に反映されます。LARUbotの管理画面には「テスト対話(プレビュー)機能」が標準搭載されているため、登録したデータに基づいてAIが正しく回答できるかを、一般公開する前にその場ですぐにテスト・確認することができます。 Q: AIとの会話ログをエクスポートして、学習データの改善に活かすことはできますか? はい、可能です。LARUbotでは、これまでにAIが顧客や社員と行ったすべての会話ログをCSV形式でエクスポートできます。ログを分析することで、「ユーザーがどのような疑問を持っているのか」「AIがうまく答えられなかった質問(ナレッジの不足)は何か」を特定し、PDFやQ&Aデータを追加・更新していくことで、チャットボットの回答精度を継続的に高めていくPDCAサイクルを回せます。自律型ビジネスOSとしてのAIチャットボットを構築するために
AIチャットボットに自社データを学習させるプロセスは、2026年現在、かつてないほどシンプルになりました。しかし、技術的なハードルが下がったからこそ、競合他社と差がつくのは「学習させるデータの整理(前処理)」と「チャットボットを単なるFAQツールで終わらせない仕組みづくり」です。
不適切なデータ構造のまま学習をさせたり、セキュリティが不透明な海外ツールに機密情報をアップロードしたりしては、期待した成果は得られません。まずは自社のナレッジを整理し、安全かつ簡単にRAGを構築できる国産ツールでスモールスタートすることをお勧めします。
株式会社LaruVisonaが提供する「LARUbot」は、初期費用0円、最低利用期間なしで、すべての機能を体験できる約30日間の初月無料トライアルを提供しています。ぜひ、実際の自社データを読み込ませて、最短10分で構築できる自社専用AIの圧倒的な回答精度と、顧客管理や決済までを自動化する「ビジネスOS」としての実力を体感してください。
まずは約30日間の無料トライアルで、自社データの学習精度を体感してみませんか?
初期費用0円、最低利用期間なし。アカウント作成は最短1分で完了し、すぐにPDFやURLの学習テストを開始できます。
LARUbotの料金プラン・無料トライアルはこちら